KI-Crawler steuern (GPTBot, ClaudeBot & Co.)
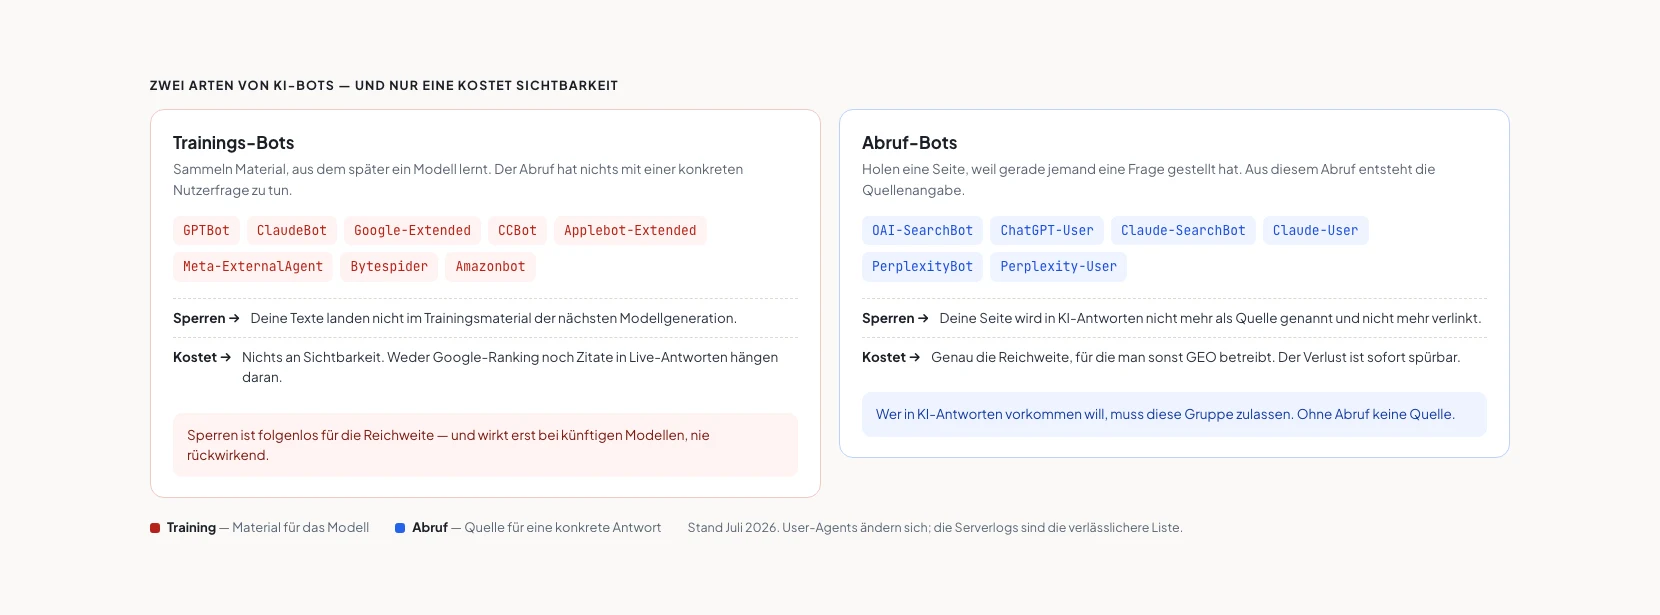
KI-Crawler steuerst du über User-Agent-Regeln in der robots.txt. Entscheidend ist dabei die Trennung zwischen Trainings-Bots, die Material für künftige Modelle sammeln, und Abruf-Bots, die deine Seite live holen, wenn jemand eine Frage stellt. Trainings-Bots kannst du sperren, ohne Sichtbarkeit zu verlieren; sperrst du die Abruf-Bots, verschwindest du aus den Quellenangaben von ChatGPT, Claude und Perplexity.
Das Wichtigste in Kürze
- Trainings-Bots (
GPTBot,ClaudeBot,Google-Extended,CCBot,Applebot-Extended) sammeln Material für künftige Modelle. Eine Sperre kostet keine Reichweite und wirkt nur nach vorn. Bereits gecrawlte Inhalte holt sie nicht zurück. - Abruf-Bots (
OAI-SearchBot,ChatGPT-User,Claude-SearchBot,Claude-User,PerplexityBot) holen deine Seite wegen einer konkreten Nutzerfrage. Wer sie sperrt, wird in KI-Antworten nicht mehr als Quelle genannt. Google-Extendedsteuert ausschließlich die KI-Nutzung durch Gemini und die Grounding-Daten. Das reguläre Google-Ranking hängt weiter amGooglebotund bleibt unberührt.- Ein Crawler folgt immer nur einer Regelgruppe (der spezifischsten, die auf ihn passt). Wer
GPTBoteine eigene Gruppe gibt, hebt für ihn alle Regeln unterUser-agent: *auf. Das ist die häufigste stille Fehlkonfiguration. - Die
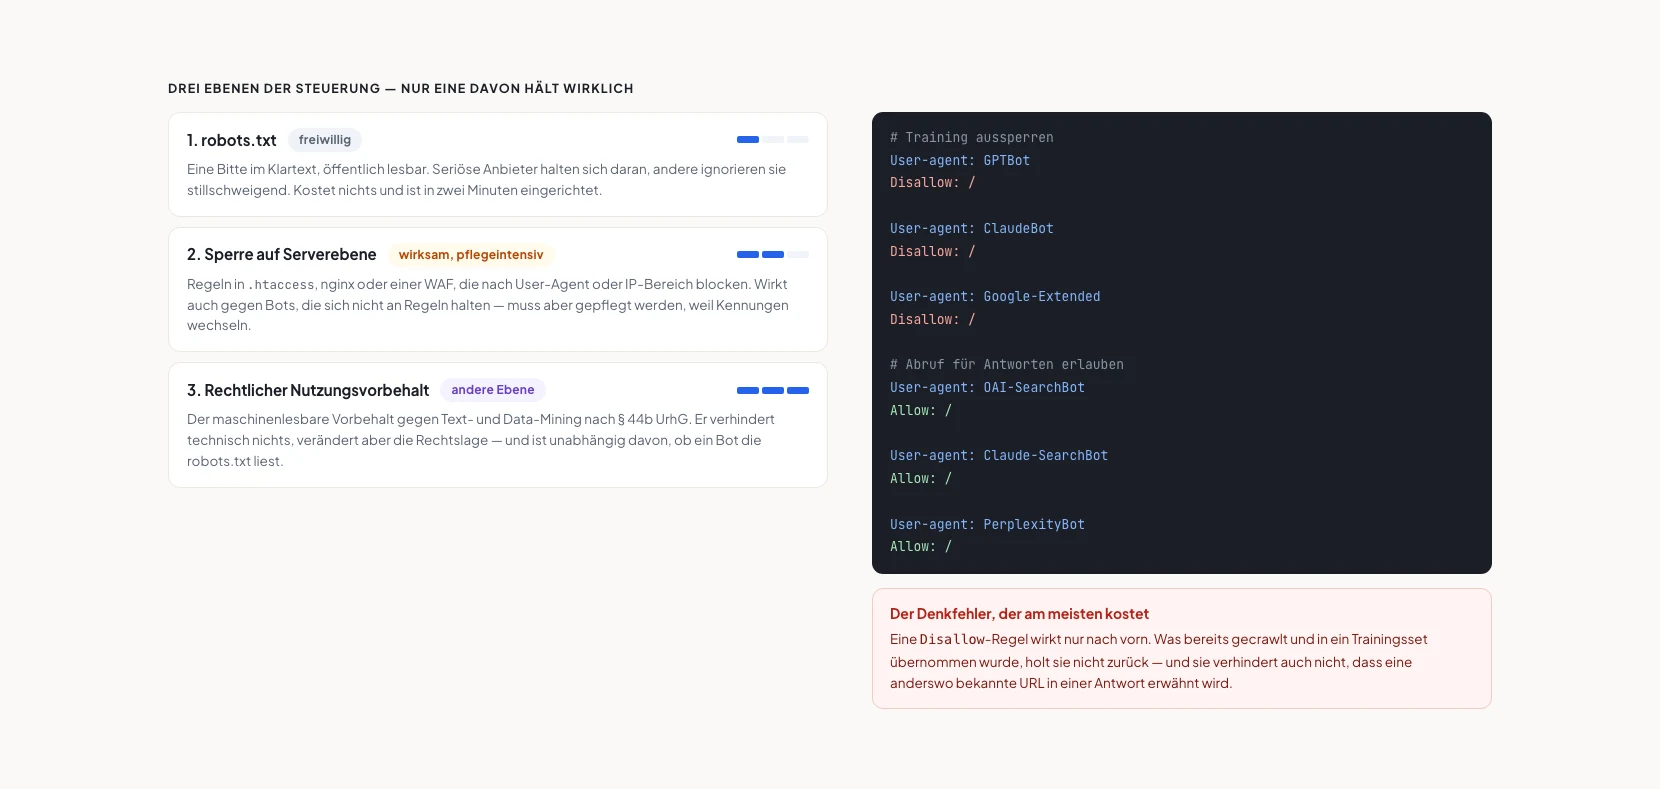
robots.txtist nach RFC 9309 eine Bitte, kein Riegel. Technisch durchsetzbar wird eine Sperre erst auf Serverebene, etwa per.htaccessoder WAF-Regel. - Seit dem 2. August 2025 gelten die Urheberrechtspflichten der EU-KI-Verordnung für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck; der zugehörige Verhaltenskodex verpflichtet die Unterzeichner ausdrücklich darauf, die
robots.txtzu beachten. - Der urheberrechtliche Nutzungsvorbehalt nach § 44b Abs. 3 UrhG ist eine eigene Ebene: Er verhindert technisch nichts, verändert aber die Rechtslage und muss maschinenlesbar sein.
- Diese Website lässt beide Bot-Arten zu. Der Grund steht weiter unten, und er ist nicht für jeden Anbieter der richtige.
Wer da eigentlich crawlt
Ein Blick in ein durchschnittliches Serverlog reicht, um zu merken, dass „KI-Bot“ keine Kategorie ist, sondern ein Sammelbegriff für sehr verschiedene Programme mit sehr verschiedenen Absichten. Stand Juli 2026 sind das die Kennungen, die in deutschen Access-Logs regelmäßig auftauchen:
| User-Agent | Betreiber | Was er tut |
|---|---|---|
GPTBot |
OpenAI | Training künftiger Modelle |
OAI-SearchBot |
OpenAI | Indexierung für die ChatGPT-Suche |
ChatGPT-User |
OpenAI | Einzelabruf, weil ein Nutzer gerade fragt |
ClaudeBot |
Anthropic | Training künftiger Modelle |
Claude-SearchBot |
Anthropic | Indexierung für Suchergebnisse in Claude |
Claude-User |
Anthropic | Einzelabruf auf Nutzeranfrage |
Google-Extended |
Steuermarke für KI-Training und Grounding | |
PerplexityBot |
Perplexity | Index für Antworten mit Quellenangabe |
Perplexity-User |
Perplexity | Einzelabruf auf Nutzeranfrage |
CCBot |
Common Crawl | offener Datensatz, der vielfach zum Training dient |
Applebot-Extended |
Apple | Steuermarke für KI-Training |
Meta-ExternalAgent |
Meta | Training und Produktdaten |
Bytespider |
ByteDance | Training, gilt als besonders aggressiv |
Amazonbot |
Amazon | Produkt- und Assistenzdaten |
Zwei Einträge in dieser Liste sind Sonderfälle, weil sie gar keine Crawler sind. Google-Extended und Applebot-Extended beschreiben keinen eigenen Bot, der bei dir klopft. Sie sind reine Steuermarken. Google und Apple crawlen mit ihrem normalen Suchmaschinen-Bot und werten diese Kennung anschließend aus, um zu entscheiden, ob die gefundenen Inhalte in die KI-Verwertung dürfen. Du wirst sie deshalb im Log nie sehen, obwohl die Regel wirkt.
 Vergrößern: Die Trennung, an der jede Entscheidung hängt: Nur die rechte Spalte kostet…
Warum die Unterscheidung wirklich zählt
„KI-Bots aussperren“ liest man oft als eine einzige Entscheidung. Sie ist es nicht. Das ist der Punkt, an dem die meisten deutschsprachigen Anleitungen zum Thema aufhören.
Ein Trainings-Bot lädt deinen Text, damit er irgendwann Teil des Materials wird, aus dem ein Modell seine Sprachfähigkeit ableitet. Ob dein Artikel dabei war oder nicht, merkt hinterher niemand (auch du nicht). Es gibt keinen Rückkanal, keinen Verweis, keinen Klick. Sperrst du diese Gruppe, verlierst du also nichts, was messbar wäre.
Ein Abruf-Bot dagegen kommt, weil in diesem Moment jemand eine Frage gestellt hat, zu der deine Seite passt. Was er holt, landet direkt in der Antwort. Eine Quellenangabe, die als Link anklickbar ist, gehört dazu. Diese Abrufe sind der gesamte Kanal, um den es bei Generative Engine Optimization geht. Wer ihn zumacht, betreibt kein Rechtemanagement, sondern schaltet seine eigene Sichtbarkeit ab.
Die Zwischenform sind die …-User-Kennungen. ChatGPT-User, Claude-User und Perplexity-User markieren Abrufe, die eine einzelne Person direkt ausgelöst hat, etwa indem sie eine URL in den Chat gepasted hat. Sie crawlen nichts systematisch und sind technisch näher an einem Browser als an einem Bot. Sie zu sperren heißt: Wenn jemand deine eigene Seite in ChatGPT einfügt, um sich einen Absatz erklären zu lassen, bekommt er eine Fehlermeldung.
Die robots.txt schreiben
Die Datei liegt im Wurzelverzeichnis unter https://deine-domain.de/robots.txt und ist öffentlich lesbar (auch für Wettbewerber, die dort gern nachsehen). Der Aufbau, der Training aussperrt und Abrufe zulässt, sieht so aus:
# Training untersagen
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Bytespider
Disallow: /

# Live-Abruf für Antworten erlauben
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Für alle übrigen gilt weiterhin
User-agent: *
Disallow: /intern/
Sitemap: https://deine-domain.de/sitemap-index.xml
Drei Details daran sind wichtiger, als sie aussehen.
Ein Bot folgt genau einer Gruppe. Nach RFC 9309 sucht ein Crawler die spezifischste Gruppe, deren User-agent auf ihn passt, und ignoriert alle anderen vollständig (auch User-agent: *). Wenn du also unter * sinnvolle Ausschlüsse stehen hast (Suchergebnisse, Warenkorb, Druckansichten) und weiter oben eine eigene Gruppe für GPTBot anlegst, dann gelten für GPTBot nur die Zeilen in seiner eigenen Gruppe. Alles, was du unter * für alle geregelt hast, ist für ihn weg. Das ist der Fehler, den ich in Audits am häufigsten sehe, und er fällt nicht auf, weil nichts kaputtgeht. Es wird nur mehr gecrawlt als gedacht.
Allow: / ist meist redundant, aber nützlich. Ohne jede Regel ist Crawlen ohnehin erlaubt. Die Zeile dokumentiert die Absicht (für Kollegen, die die Datei später anfassen, und für dich selbst in einem Jahr). Sie schadet nicht.
Groß- und Kleinschreibung. Der Pfad in Disallow ist case-sensitiv, der User-Agent-Name nicht. gptbot funktioniert also, /Intern/ und /intern/ sind aber zwei verschiedene Dinge. Prüfen lässt sich das Ergebnis mit dem robots.txt-Tester in der Google Search Console. Der prüft zwar nur den Googlebot, deckt aber Syntaxfehler zuverlässig auf. Mehr zur Datei selbst steht unter robots.txt & Sitemaps.
 Vergrößern: Drei Ebenen, drei Wirkungsgrade, und nur die mittlere lässt sich technisch…
Wo die robots.txt aufhört
Die Datei ist eine Konvention, kein Zugriffsschutz. Sie steht öffentlich im Netz und verlässt sich darauf, dass der Gegenüber sie liest und respektiert. Die großen Anbieter tun das inzwischen nachprüfbar; Scraper aus der zweiten Reihe tun es nicht, und manche tarnen sich schlicht als normaler Browser.
Wer eine Sperre erzwingen will, braucht eine Regel auf dem Server. Für Apache sieht das etwa so aus:
# .htaccess blockt nach User-Agent, unabhängig von der robots.txt
<IfModule mod_rewrite.c>
  RewriteEngine On
  RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider) [NC]
  RewriteRule ^ - [F,L]
</IfModule>
Der Preis dafür ist Pflege: User-Agent-Kennungen wechseln, neue Anbieter kommen dazu, und wer zu grob filtert, sperrt irgendwann versehentlich einen Dienst aus, den er braucht. Ein zweiter Weg ist die Bot-Verwaltung eines vorgelagerten CDN. Dort lassen sich KI-Crawler seit 2024 zentral steuern, ohne dass man Kennungen selbst pflegen muss.
Und dann ist da noch die Sache mit der Reichweite einer Sperre: Disallow wirkt nur nach vorn. Was in den Jahren davor gecrawlt und in einen Datensatz übernommen wurde, bleibt dort. Auch die Erwähnung einer URL in einer Antwort verhindert die Regel nicht zuverlässig, wenn dieselbe URL an anderer Stelle im Netz verlinkt ist (ein Effekt, den man von der klassischen Suche kennt).
Die rechtliche Ebene: § 44b UrhG
Technische Steuerung und Rechtslage sind zwei Paar Schuhe, und sie werden ständig durcheinandergeworfen. Ein Überblick, ohne Rechtsberatung zu sein:
§ 44b UrhG erlaubt Vervielfältigungen für Text und Data Mining. Es sei denn, die Rechteinhaberin hat sich das vorbehalten. Für online zugängliche Werke ist ein solcher Vorbehalt nach Absatz 3 nur dann wirksam, wenn er in maschinenlesbarer Form erklärt wird. Genau hier setzt die robots.txt an: Sie ist der etablierteste maschinenlesbare Kanal, den es dafür gibt.
Wie weit „maschinenlesbar“ reicht, ist umstritten. Im Verfahren Kneschke gegen LAION hat das LG Hamburg am 27. September 2024 (Az. 310 O 227/23) die Auffassung vertreten, auch ein Vorbehalt in natürlicher Sprache könne genügen, weil heutige KI-Systeme natürliche Sprache verstehen. In der Berufung hat das OLG Hamburg das enger gesehen: Der Rechteinhaber trägt die Beweislast dafür, dass sein Vorbehalt zum Zeitpunkt der Nutzung maschinenlesbar war, und ein Satz in den Nutzungsbedingungen reicht dafür nicht.
Für die Praxis heißt das: Wer sich auf einen Vorbehalt berufen will, sollte ihn dort hinterlegen, wo Maschinen ohnehin nachsehen: in der robots.txt und ergänzend in den Nutzungsbedingungen. Beides zusammen ist mehr wert als eines davon.
Dazu kommt seit dem 2. August 2025 die EU-KI-Verordnung. Anbieter von KI-Modellen mit allgemeinem Verwendungszweck müssen seither eine Strategie zur Einhaltung des Urheberrechts vorhalten und maschinenlesbare Rechtevorbehalte erkennen und beachten. Der im Juli 2025 veröffentlichte Verhaltenskodex für solche Modelle nennt die Beachtung der robots.txt ausdrücklich als Verpflichtung der Unterzeichner. Eine Sperre in dieser Datei ist damit rechtlich deutlich mehr wert als noch vor zwei Jahren.
Kein Rechtsrat. Ich ordne hier öffentlich zugängliche Entwicklungen ein. Ob und wie du einen Nutzungsvorbehalt erklärst, ist eine juristische Entscheidung. Im Zweifel sollte das fachlich geprüft werden.
Nachsehen, wer tatsächlich vorbeikommt
Bevor man Regeln schreibt, lohnt sich ein Blick ins Access-Log. Der zeigt, welche Bots die eigene Seite überhaupt besuchen und mit welcher Frequenz. Der Befund weicht dabei oft von der Erwartung ab:
grep -Ei 'gptbot|claudebot|perplexitybot|ccbot|bytespider|oai-searchbot' access.log \
  | awk '{print $12}' | sort | uniq -c | sort -rn | head -20
Die Feldnummer hängt vom Logformat ab; bei kombiniertem Apache-Format steht der User-Agent am Zeilenende. Wer kein Log hat, sieht in der Serverstatistik des Hosters nach. Die meisten Panels zeigen dort eine Bot-Auswertung.
Bei dieser Website ist die Verteilung eindeutig: Die Abruf-Bots kommen selten, aber gezielt und meist auf eine einzelne, thematisch passende Seite. Bytespider und CCBot dagegen ziehen in Wellen ganze Verzeichnisse durch. Wer nur ein kleines Hosting-Paket hat, merkt den Unterschied an der Serverlast, bevor er ihn im Log sieht.
KI-Sichtbarkeits-Plugin für WordPress
Der grep oben setzt voraus, dass du an dein Access-Log kommst. Bei einem Shared-Hosting-Paket ist das oft nicht der Fall, und die Bot-Statistik im Hoster-Panel wirft Suchmaschinen- und KI-Crawler meist in einen Topf. Für WordPress-Websites gibt es dafür eine Abkürzung: die GEO Copilot Suite, ein KI-Sichtbarkeits-Plugin aus meinem Partnerprojekt seo-copilot.de. Es schreibt die Zugriffe in die eigene Datenbank, ordnet jede Kennung einem der Zwecke zu, um die es auf dieser Seite geht (Modelltraining, KI-Suche, Abruf auf Nutzeranfrage, KI-Agent), und bringt einen robots.txt-Manager mit, der dieselbe Trennung als Voreinstellung anbietet. Stand August 2026 liegt es in Version 1.4.7 vor, ist unter GPLv2 kostenlos und setzt WordPress 6.4 sowie PHP 8.1 voraus.
Ich habe es auf einer Test-Instanz installiert, um zu sehen, was auf einer frisch aufgesetzten Website ohne einen einzigen eingehenden Link überhaupt ankommt. Das Ergebnis nach wenigen Stunden hat mich dann doch überrascht:
 Vergrößern: Die ersten Stunden einer Test-Instanz: 37 Zugriffe von sechs Kennungen. 34…
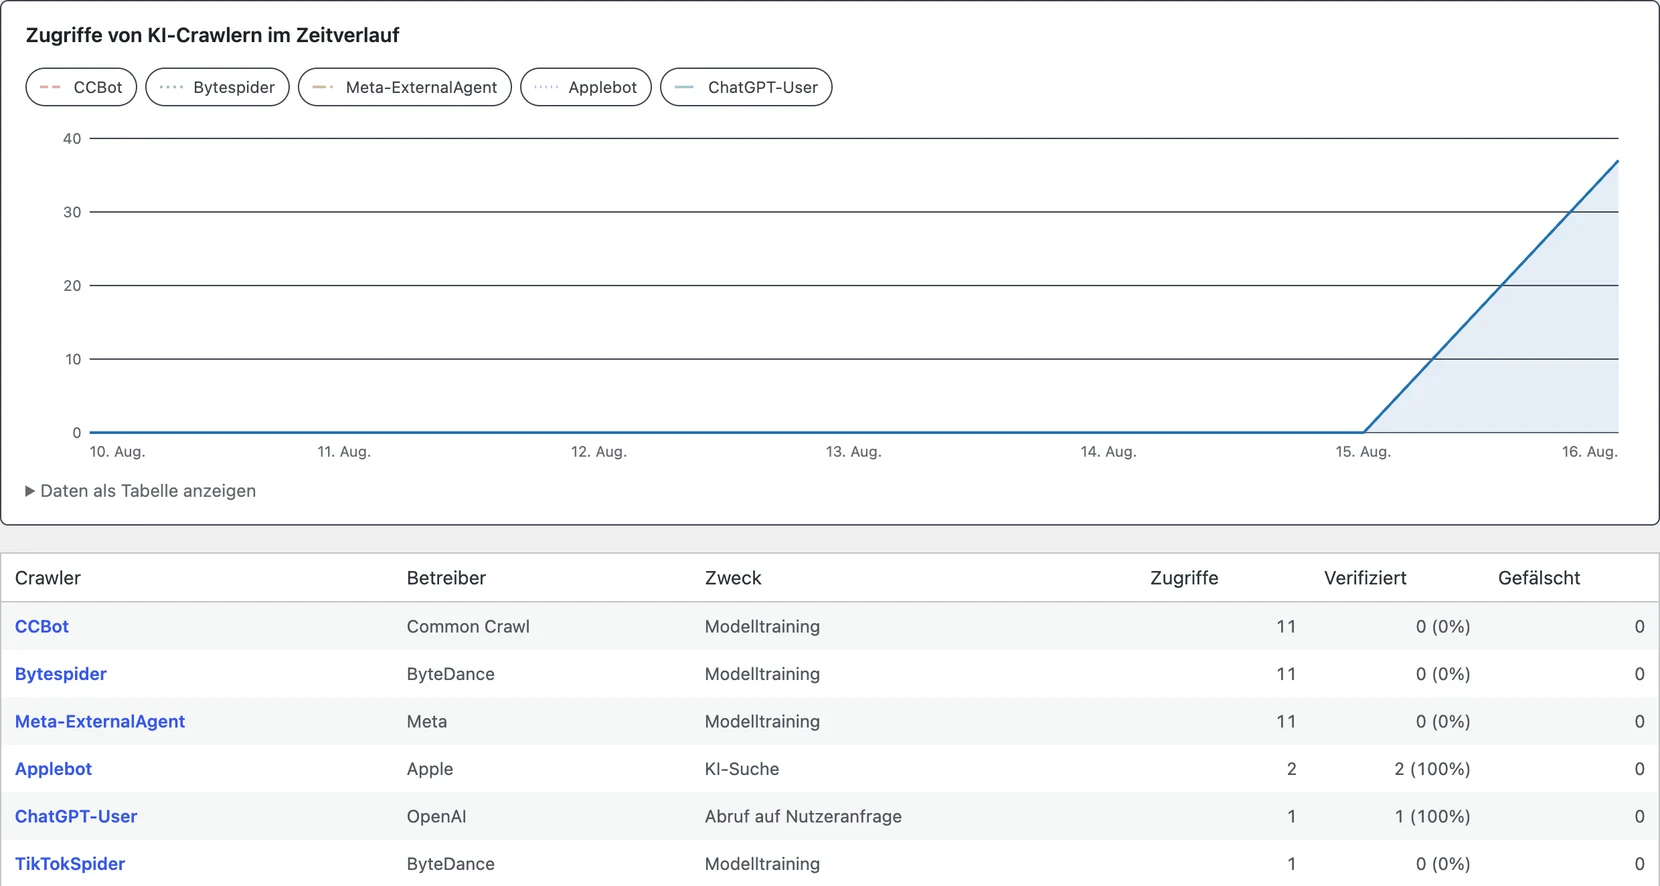
37 Zugriffe von sechs verschiedenen Kennungen, auf einer Domain, die zu diesem Zeitpunkt noch niemand verlinkt hatte. Interessanter als die Summe ist ihre Verteilung: 34 davon gingen auf das Konto der Trainings-Bots (CCBot, Bytespider, Meta-ExternalAgent, TikTokSpider), 3 auf die Abruf-Seite. Davon gingen zwei an Applebot für die KI-Suche, einer an ChatGPT-User für einen Abruf auf Nutzeranfrage. Genau das Verhältnis, das dieser Artikel beschreibt, nur deutlicher, als ich es erwartet hatte. Wer noch überlegt, ob sich die Frage „Training sperren oder nicht“ überhaupt lohnt: Sie stellt sich ab dem ersten Tag, nicht ab dem ersten Besucher.
Eine Spalte dieser Tabelle wird dabei leicht falsch gelesen. „0 % verifiziert“ heißt nicht „gefälscht“. Das Plugin gleicht jeden Zugriff gegen die IP-Bereiche ab, die die Betreiber selbst veröffentlichen. Stand August 2026 tun das unter anderem OpenAI, Google, Perplexity, Apple und DuckDuckGo, aber weder Common Crawl noch ByteDance noch Meta. Deren Zugriffe landen deshalb bei „nicht verifizierbar“, während die eigene Spalte „Gefälscht“ bei null bleibt. Der Unterschied ist praktisch relevant: Wer beides verwechselt, sperrt Crawler aus, die echt sind. Umgekehrt übersieht er, dass sich ein vorgetäuschter GPTBot genau in der Spalte zeigen würde, in der jetzt eine Null steht.
Eine Einschränkung gilt für jeden Zähler, der in PHP hängt, und das Plugin benennt sie selbst: Ein Full-Page-Cache beantwortet die meisten Anfragen, ohne PHP überhaupt zu starten. Was von dort ausgeliefert wird, taucht in keiner Statistik auf. Die Zahlen sind also eine Untergrenze, kein vollständiges Bild. Wer ein Access-Log hat, behält damit die genauere Quelle.
Offenlegung. Die GEO Copilot Suite stammt aus meinem Partnerprojekt seo-copilot.de, ich bin an ihr also nicht unbeteiligt. Ich nenne sie hier, weil sie die Trennung nach Zweck abbildet, um die es auf dieser Seite geht. Prüf sie trotzdem mit demselben Misstrauen wie jedes andere Plugin, das du in eine Website einbaust.
Meine Entscheidung und warum sie nicht für alle taugt
Diese Website lässt beide Bot-Arten zu, Training eingeschlossen. Der Grund ist schlicht: Sie soll erklären, wie Barrierefreiheit und semantisches HTML funktionieren. Wenn ein Modell diese Erklärungen mitlernt und später jemandem korrekt weitergibt, ist das Ziel erreicht (auch ohne Klick).
Ich würd das aber nicht pauschal empfehlen. Wer von Inhalten lebt, die exklusiv sein müssen (Kursmaterial, Bezahlinhalte, Datenbanken mit eigener Erhebung), hat den umgekehrten Fall: Da ist jeder Trainingsabruf ein Verlust ohne Gegenwert. Entscheidend ist: Verdienst du am Zugriff auf deinen Inhalt oder an seiner Verbreitung?
Eine dritte Gruppe gibt es auch, und sie wird selten benannt: Websites, deren Serverkapazität das Problem ist. Wenn ein Crawler mehrere tausend Seiten am Tag zieht, ist das ein Kostenfaktor, ganz unabhängig von jeder Haltung zum Thema. Dann ist die Sperre eine Betriebsentscheidung.
Praktisch laufen alle drei Fälle auf drei Konfigurationen hinaus, und eine vierte braucht kaum jemand: alles zulassen bei lokalen Anbietern und Dienstleistern, die von Auffindbarkeit leben und deren Texte ohnehin niemand kauft; Training sperren, Abruf erlauben bei Verlagen, Fachmedien und allen, deren Inhalt selbst das Produkt ist; alles sperren nur dort, wo ohnehin eine Bezahlschranke davorsteht (hinter der die Bots sowieso nicht weiterkommen). Welches Profil zu welchem Geschäftsmodell passt und was die jeweilige Entscheidung an Sichtbarkeit kostet, ist auf dem Partnerprojekt seo-copilot.de unter KI-Crawler erlauben oder blockieren? mit fertigen Beispielkonfigurationen durchgespielt.
Häufiger Fehler in der Praxis
Alles blocken und sich über die Unsichtbarkeit wundern. Der häufigste Fall: Jemand kopiert eine Liste „KI-Bots aussperren“ aus einem Blogartikel, setzt sie ein und stellt Monate später fest, dass die eigene Seite in keiner KI-Antwort mehr auftaucht. Die Ursache steht dann in der eigenen robots.txt (zwei Zeilen zu viel).
Google-Extended mit dem Ranking verwechseln. Die Kennung betrifft ausschließlich die KI-Verwertung. Wer sie sperrt, ändert an seiner Position in der klassischen Google-Suche exakt nichts. Umgekehrt gilt: Wer in den AI Overviews auftauchen will, sollte sie nicht sperren.
Tippfehler im User-Agent. GPT-Bot, Claudebot, Perplexity-Bot. Jede dieser Schreibweisen passt auf keinen realen Crawler, und die Regel läuft ins Leere. Der Name ist immer die exakte Zeichenfolge aus der Dokumentation des Anbieters.
Die Datei als Sicherheitsmaßnahme missverstehen. Wer nicht öffentliche Pfade per Disallow „schützt“, hat sie in Wahrheit veröffentlicht: Die robots.txt ist der erste Ort, an dem jemand nachsieht, der etwas sucht. Nicht öffentliche Bereiche gehören hinter eine Authentifizierung, nicht in eine Textdatei.
Regeln setzen, ohne sie je wieder anzusehen. Neue Bots kommen alle paar Monate dazu. Eine Liste von 2024 kennt weder Claude-SearchBot noch Meta-ExternalAgent. Ein Kalendereintrag pro Halbjahr reicht völlig.
Häufige Fragen
Schadet das Zulassen von KI-Bots meinem Google-Ranking?
Nein. KI-Crawler und Suchmaschinen-Crawler sind getrennte Systeme mit eigenen User-Agents. Dein Ranking hängt am Googlebot; weder GPTBot noch ClaudeBot noch Google-Extended haben darauf Einfluss. Auch die Serverlast ist bei normal großen Websites kein Rankingfaktor, solange die Antwortzeiten stabil bleiben.
Kann ich meine Inhalte nachträglich aus einem Modell entfernen lassen?
Praktisch nicht. Was in einem Trainingsdatensatz gelandet ist, lässt sich nicht per robots.txt zurückholen. Die Regel gilt ab dem nächsten Crawl. Einzelne Anbieter bieten Formulare für Löschanfragen an, deren Wirkung auf ein bereits trainiertes Modell aber begrenzt ist. Wer Inhalte schützen will, muss das tun, bevor sie öffentlich stehen.
Ersetzt die llms.txt die robots.txt?
Nein, sie verfolgt das gegenteilige Ziel. Die llms.txt sperrt nichts aus, sondern lädt ein: Sie weist KI-Systemen den Weg zu den Kerninhalten einer Website in aufbereiteter Form. Beides lässt sich kombinieren (Training sperren, Abruf erlauben und den Abruf-Bots dann eine gute Landkarte geben).
Wie oft sollte ich die robots.txt überprüfen?
Halbjährlich reicht, plus immer dann, wenn du von einem neuen Anbieter liest. Prüfen heißt: Serverlog ansehen, unbekannte Kennungen nachschlagen, die eigenen Regeln gegen die Bot-Dokumentation der großen Anbieter abgleichen. Zehn Minuten Arbeit.
Gilt das alles auch für Bilder?
Ja, mit einer Besonderheit: Bilder werden von denselben Bots geholt, aber oft über eigene Pfade. Wer nur Bilder ausnehmen will, sperrt gezielt das Verzeichnis (Disallow: /img/) statt den ganzen Bot. Für die Auffindbarkeit in der klassischen Bildersuche gilt das dann allerdings auch. Die Abwägung dazu steht unter Bild-SEO.
Verwandte Themen
- robots.txt & Sitemaps: Syntax, Reihenfolge und die typischen Fallstricke der Datei
- llms.txt einrichten: der einladende Gegenpol zur Sperre
- GEO-Grundlagen: wie man überhaupt in KI-Antworten landet
- AI Overviews & KI-Suche: was Google mit den abgerufenen Inhalten macht
- E-E-A-T: warum Nachvollziehbarkeit für KI-Systeme dasselbe bedeutet wie für Menschen
- Semantisches HTML: die Struktur, die ein Abruf-Bot überhaupt erst auswerten kann
Quellen
- RFC 9309: Robots Exclusion Protocol (IETF: Gruppenauswahl, Syntax, Verbindlichkeit)
- OpenAI: Overview of OpenAI Crawlers (GPTBot, OAI-SearchBot, ChatGPT-User)
- Anthropic: Crawler blockieren (ClaudeBot, Claude-SearchBot, Claude-User)
- Google: Übersicht der Google-Crawler (Abgrenzung Googlebot / Google-Extended)
- § 44b UrhG: Text und Data Mining (gesetze-im-internet.de)
- GPAI Code of Practice (Europäische Kommission: Verpflichtung zur Beachtung der robots.txt)